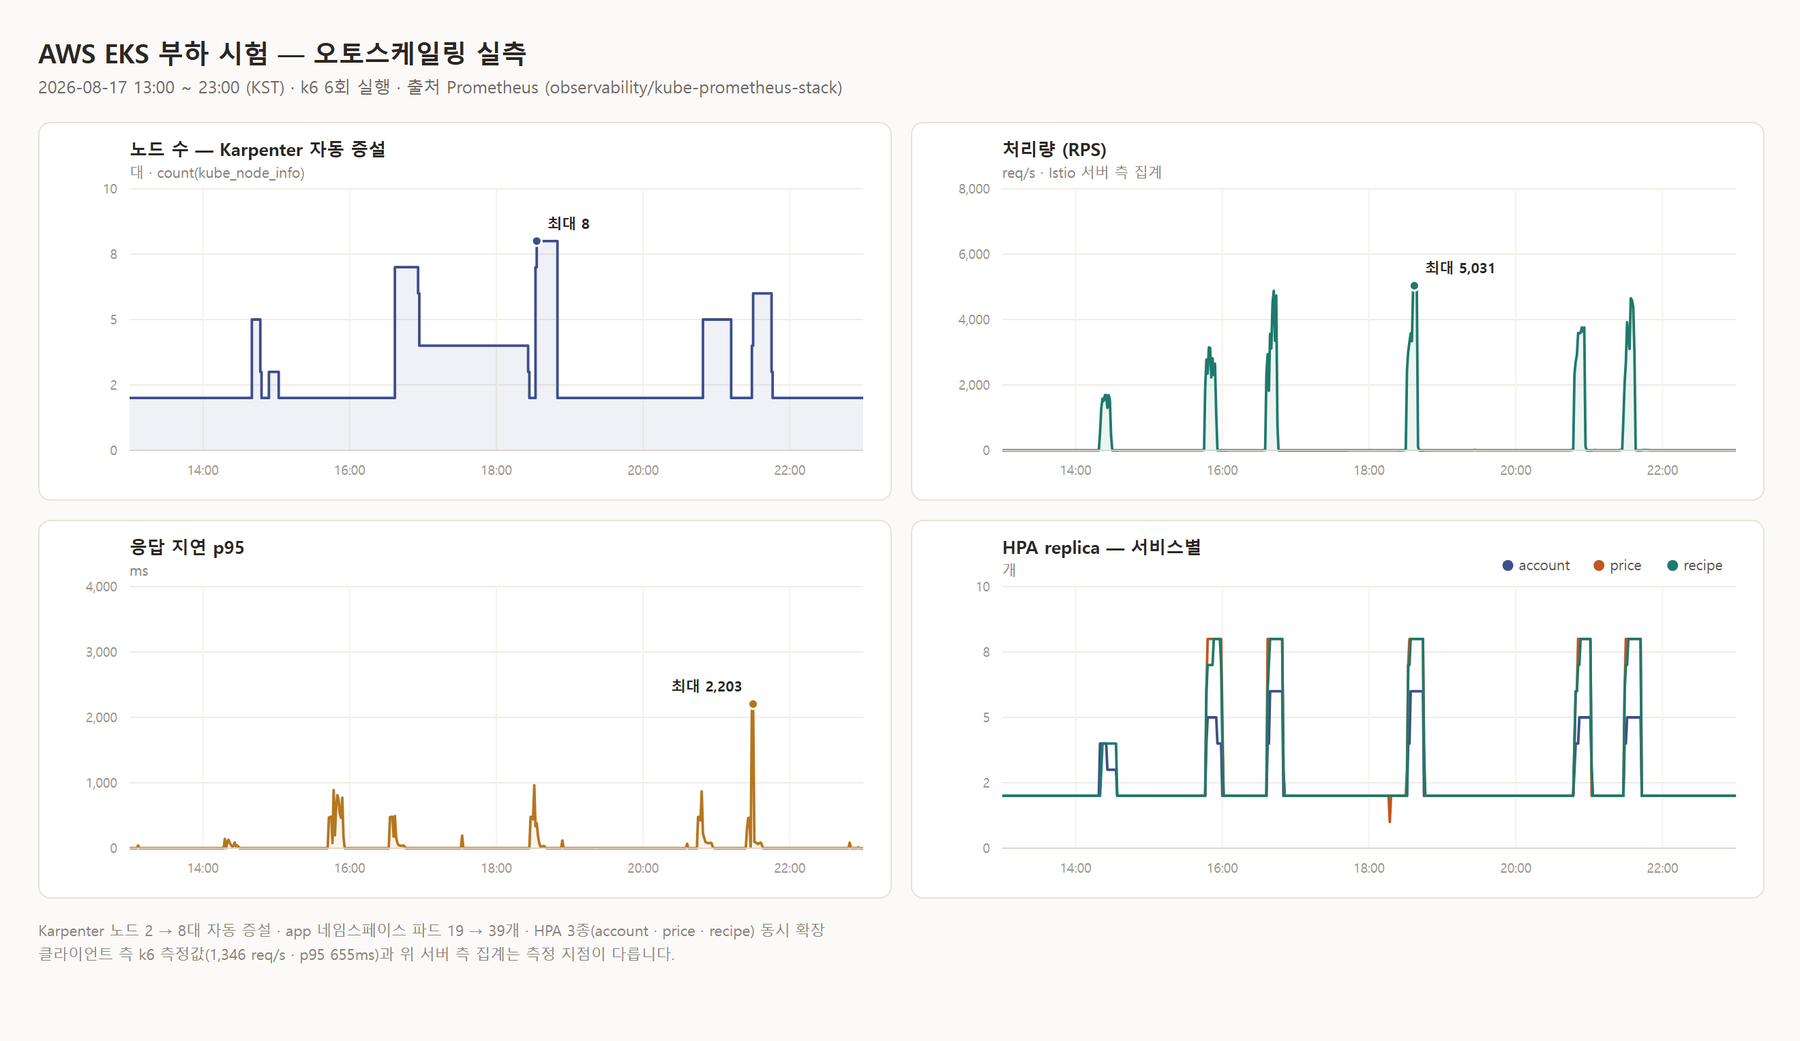
모든 수치는 2026-08 클러스터 실측값 · kubectl · AWS CLI · Prometheus 조회 기준
인프라로 옮겨온 이유
About
서비스의 안정성은 인프라 설계에서 시작된다고 판단해 전업했습니다. 온프레미스 클러스터 구축부터 AWS 이관까지 직접 수행했습니다.
전환점
2017년 그로비스인포텍에서 콘텐츠 저작도구의 프론트엔드로 2년간 일했습니다. 기능은 완성해도 배포는 매번 수작업이었고, 절차가 문서가 아니라 한 사람의 기억에 남아 있어 릴리스마다 결과를 예측할 수 없었습니다.
기능의 완성도와 무관하게 서비스가 흔들리는 상황을 반복해 겪으며, 정작 중요한 것은 그것을 떠받치는 인프라라는 사실을 알게 됐습니다.
학습 방식
컨테이너 인프라를 Kubernetes에서 시작하지 않고 docker run → Compose → Swarm → Kubernetes 순으로 밟았습니다.
Docker run은 배포를 매번 손으로 해야 했고, Compose는 호스트 한 대의 자원이 곧 한계였으며, Swarm은 무중단 배포가 되지 않았습니다. 다음 단계가 왜 필요한지 직접 겪고 넘어갔기 때문에 기술을 이름이 아니라 그것이 푸는 문제로 이해합니다.
일하는 방식
장애의 원인을 계층 단위로 좁혀 끝까지 확인합니다. 무엇을 선택했는지만큼 어떤 방법을 왜 쓰지 않기로 했는지도 남겨야 다음 사람이 같은 고민을 반복하지 않는다고 생각해, 결정과 근거를 문서로 정리합니다.
다만 그 집요함이 일정을 밀어내기 쉬워, 지금은 서비스를 되돌리는 조치와 원인을 밝히는 일을 나눠서 처리합니다.
월 식비 예산 기반 밀플래닝 서비스
Main Project
월 식비 예산을 입력하면 레시피의 재료를 추출해 마켓컬리·오아시스마켓의 현재 가격과 대조하고, 예산 안에서 한 달 식단을 계획해 주는 서비스입니다. 애플리케이션을 13종의 마이크로서비스로 분리하고, Docker에서 시작해 Kubernetes로 확장한 뒤 AWS EKS까지 세 단계로 환경을 옮겼습니다.
기간
2026.06.29 – 08.26 (59일)
팀 구성
5명 · 인프라 리드
담당
클러스터 설계·구축·운영, AWS 이관, IaC, CI/CD, 관측·보안
결과
더존비즈온 최우수상
STAGE 01Docker서비스를 이미지로 만들고 Compose로 단일 호스트에서 운영
STAGE 02Kubernetes물리 서버 3대 위 5노드 클러스터로 확장, 데이터 계층까지 인클러스터로
STAGE 03AWS EKS서비스를 멈추지 않고 같은 형상을 클라우드에 재구성
Stage 01 — Docker
먼저 컨테이너로 만들고 한 대에서 돌려보기
도메인 경계에 따라 나눈 서비스를 각각 이미지로 빌드하고, Compose로 묶어 단일 호스트에서 먼저 운영했습니다. 상주 서비스와 필요할 때만 실행하는 작업을 분리해, 같은 이미지를 compose up과 compose run --rm 두 방식으로 쓰도록 구성했습니다.
서비스 분리
데이터 파이프라인을 상주 8종(가격·레시피 정제, 특가 알림, 이상 가격 탐지, 사용자 이벤트 수집, 리텐션 정리)과 온디맨드 10종(마켓별 가격 수집, 레시피 재색인, 매트뷰 갱신, 토픽 초기화)으로 구분
이미지
멀티스테이지 Dockerfile로 빌드하고 Harbor 프라이빗 레지스트리에 등록, 태그는 환경변수로 주입해 같은 compose 파일로 버전을 바꿔 띄울 수 있게 구성
외부 의존
Kafka · PostgreSQL · Redis는 이 단계에서 아직 별도 VM에서 운영 — 컨테이너는 상태를 갖지 않고 외부 엔드포인트만 바라보도록 분리
다음 단계로 간 이유 — 호스트 한 대의 자원이 곧 상한이었고, 상주 서비스를 멈추지 않고 교체할 방법이 없었습니다. 스케줄링과 무중단 배포가 필요해 Kubernetes로 옮겼습니다.
Stage 02 — Kubernetes (온프렘)
물리 서버 3대 위 5노드 클러스터
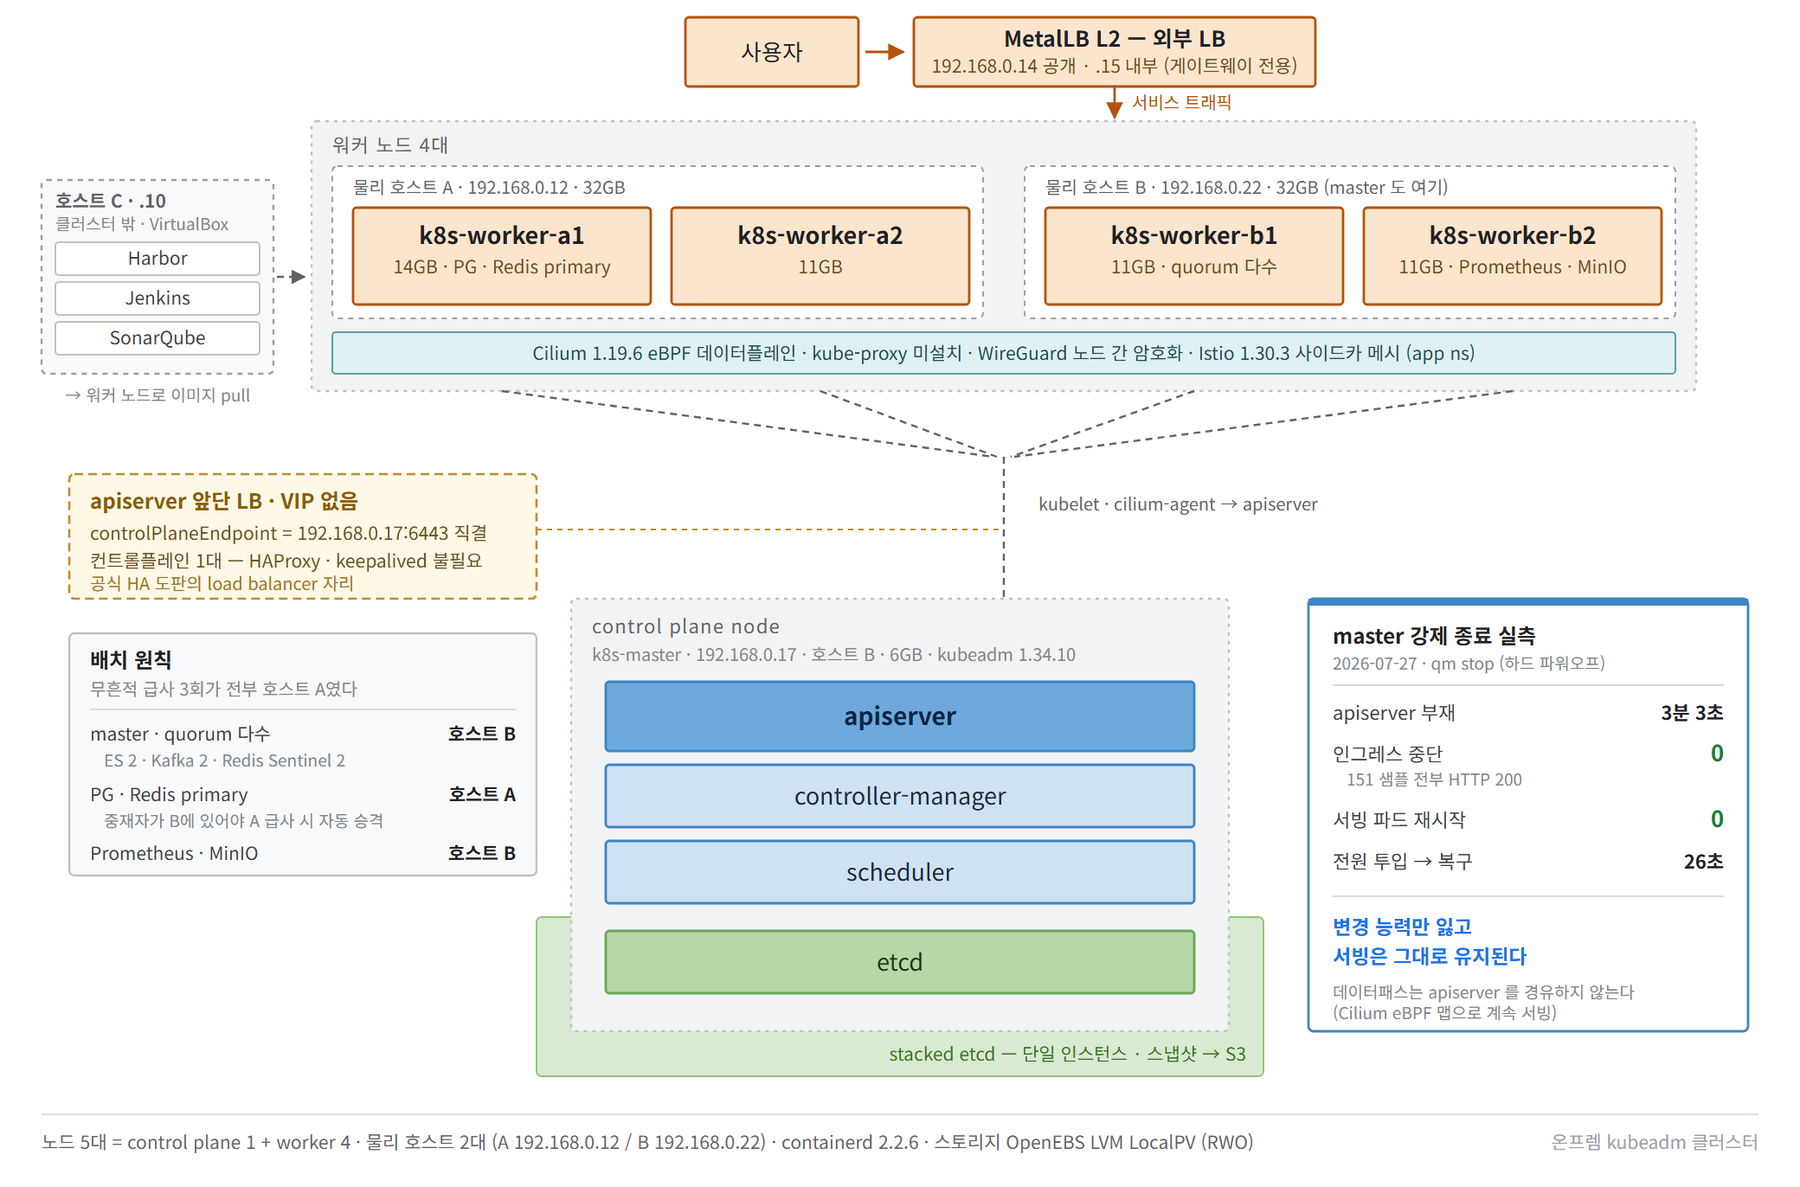
kubeadm으로 control-plane 1대와 worker 4대를 구성하고 Kubernetes 1.34.10으로 고정했습니다. 노드 배치는 장애 이력을 기준으로 정했습니다 — 예기치 않은 정지가 세 차례 모두 호스트 A에서 발생해, control-plane과 정족수 다수, 모니터링 스택은 호스트 B에 배치했습니다.
네트워크
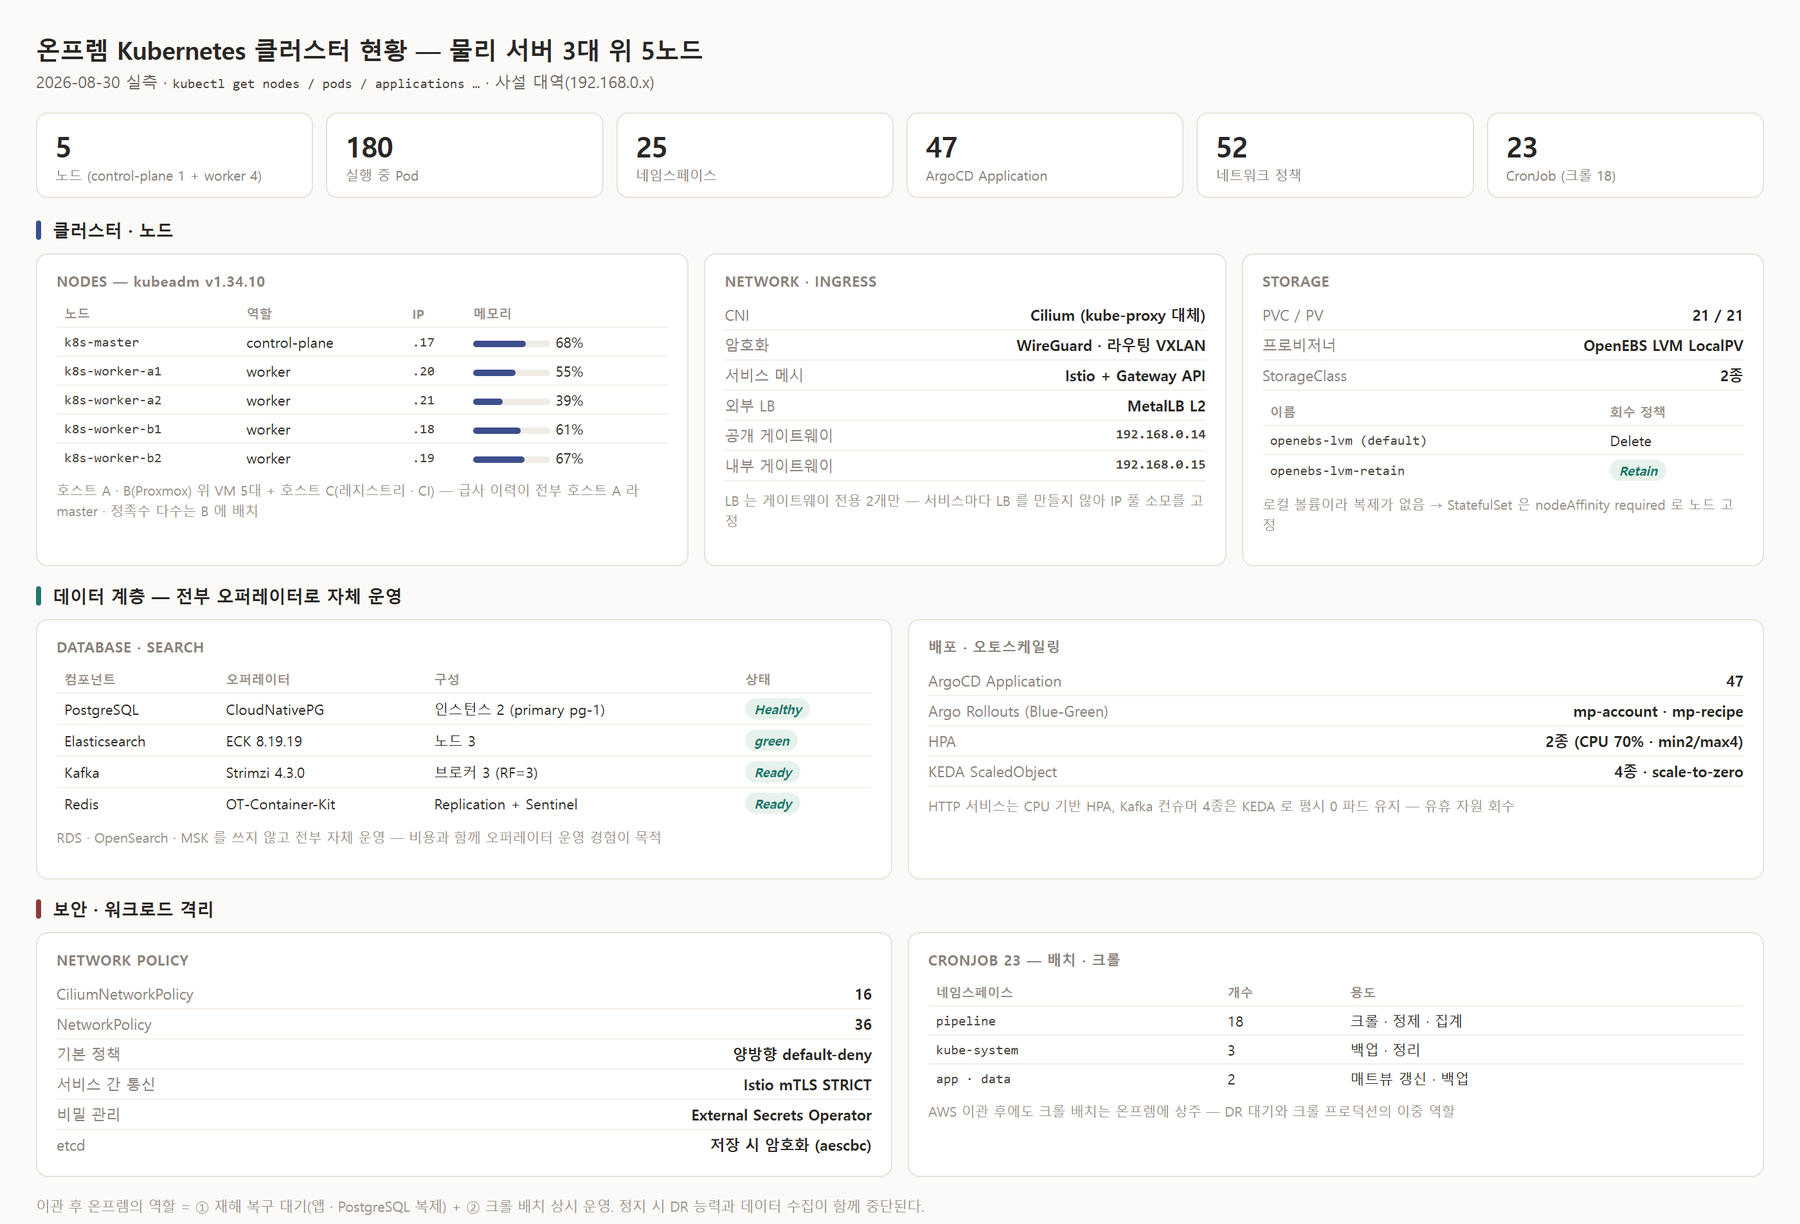
Cilium — kube-proxy를 대체해 eBPF로 서비스를 라우팅하고, 노드 간 통신은 WireGuard로 암호화. 서비스 메시는 Istio + Gateway API, 외부 진입은 MetalLB L2
데이터 계층
별도 VM 4대에서 운영하던 데이터 계층을 전부 인클러스터 오퍼레이터로 전환 — CloudNativePG(인스턴스 2), ECK(노드 3, green), Strimzi(브로커 3 · RF=3), Redis Replication + Sentinel. 컷오버는 새벽에 진행해 데이터 유실 0으로 완료
보안
네임스페이스 간 양방향 default-deny 네트워크 정책 52개, Istio mTLS STRICT, External Secrets로 평문 시크릿 제거, etcd 저장 암호화(시크릿 137개 전량 암호문 확인), CIS 하드닝
백업 · DR
PostgreSQL을 barman-cloud로 S3에 백업해 RPO 5분 · RTO 10분 확보. Elasticsearch는 PostgreSQL에서 재색인하면 복구되므로 별도 백업 없이, 복구 불가능한 데이터가 PostgreSQL뿐이라고 판단해 설계를 여기에 집중
가용성 실측
control-plane을 하드 파워오프해 검증 — apiserver 부재 3분 3초 동안 인그레스 중단 0건(151샘플 전부 HTTP 200), 서빙 파드 재시작 0. 데이터패스가 apiserver를 경유하지 않아 변경 능력만 잃고 서빙은 유지됨을 확인
온프렘 토폴로지 — 노드 배치 원칙과 control-plane 강제 종료 실측
클러스터 현황 (2026-08-30 실측) — 노드·데이터 계층·보안 정책
다음 단계로 간 이유 — 운영은 안정됐지만 물리 서버를 늘릴 수 없어 자원 배치 자체가 설계의 제약이었습니다. 같은 형상을 클라우드에서 재구성하면서 오토스케일링과 재해 복구 경로를 확보하기로 했습니다.
Stage 03 — AWS (EKS)
서비스를 멈추지 않고 형상을 옮기기
이관 중에도 서비스는 온프렘에서 계속 운영되어야 했습니다. 그래서 기존 온프렘 형상은 변경하지 않고 AWS 형상만 추가하는 방식으로 진행했습니다. Kustomize 오버레이를 온프렘용과 EKS용으로 분리해, 하나의 변경이 한쪽 클러스터에만 반영되는 것이 정상 동작이 되도록 구성했습니다.
컴퓨트
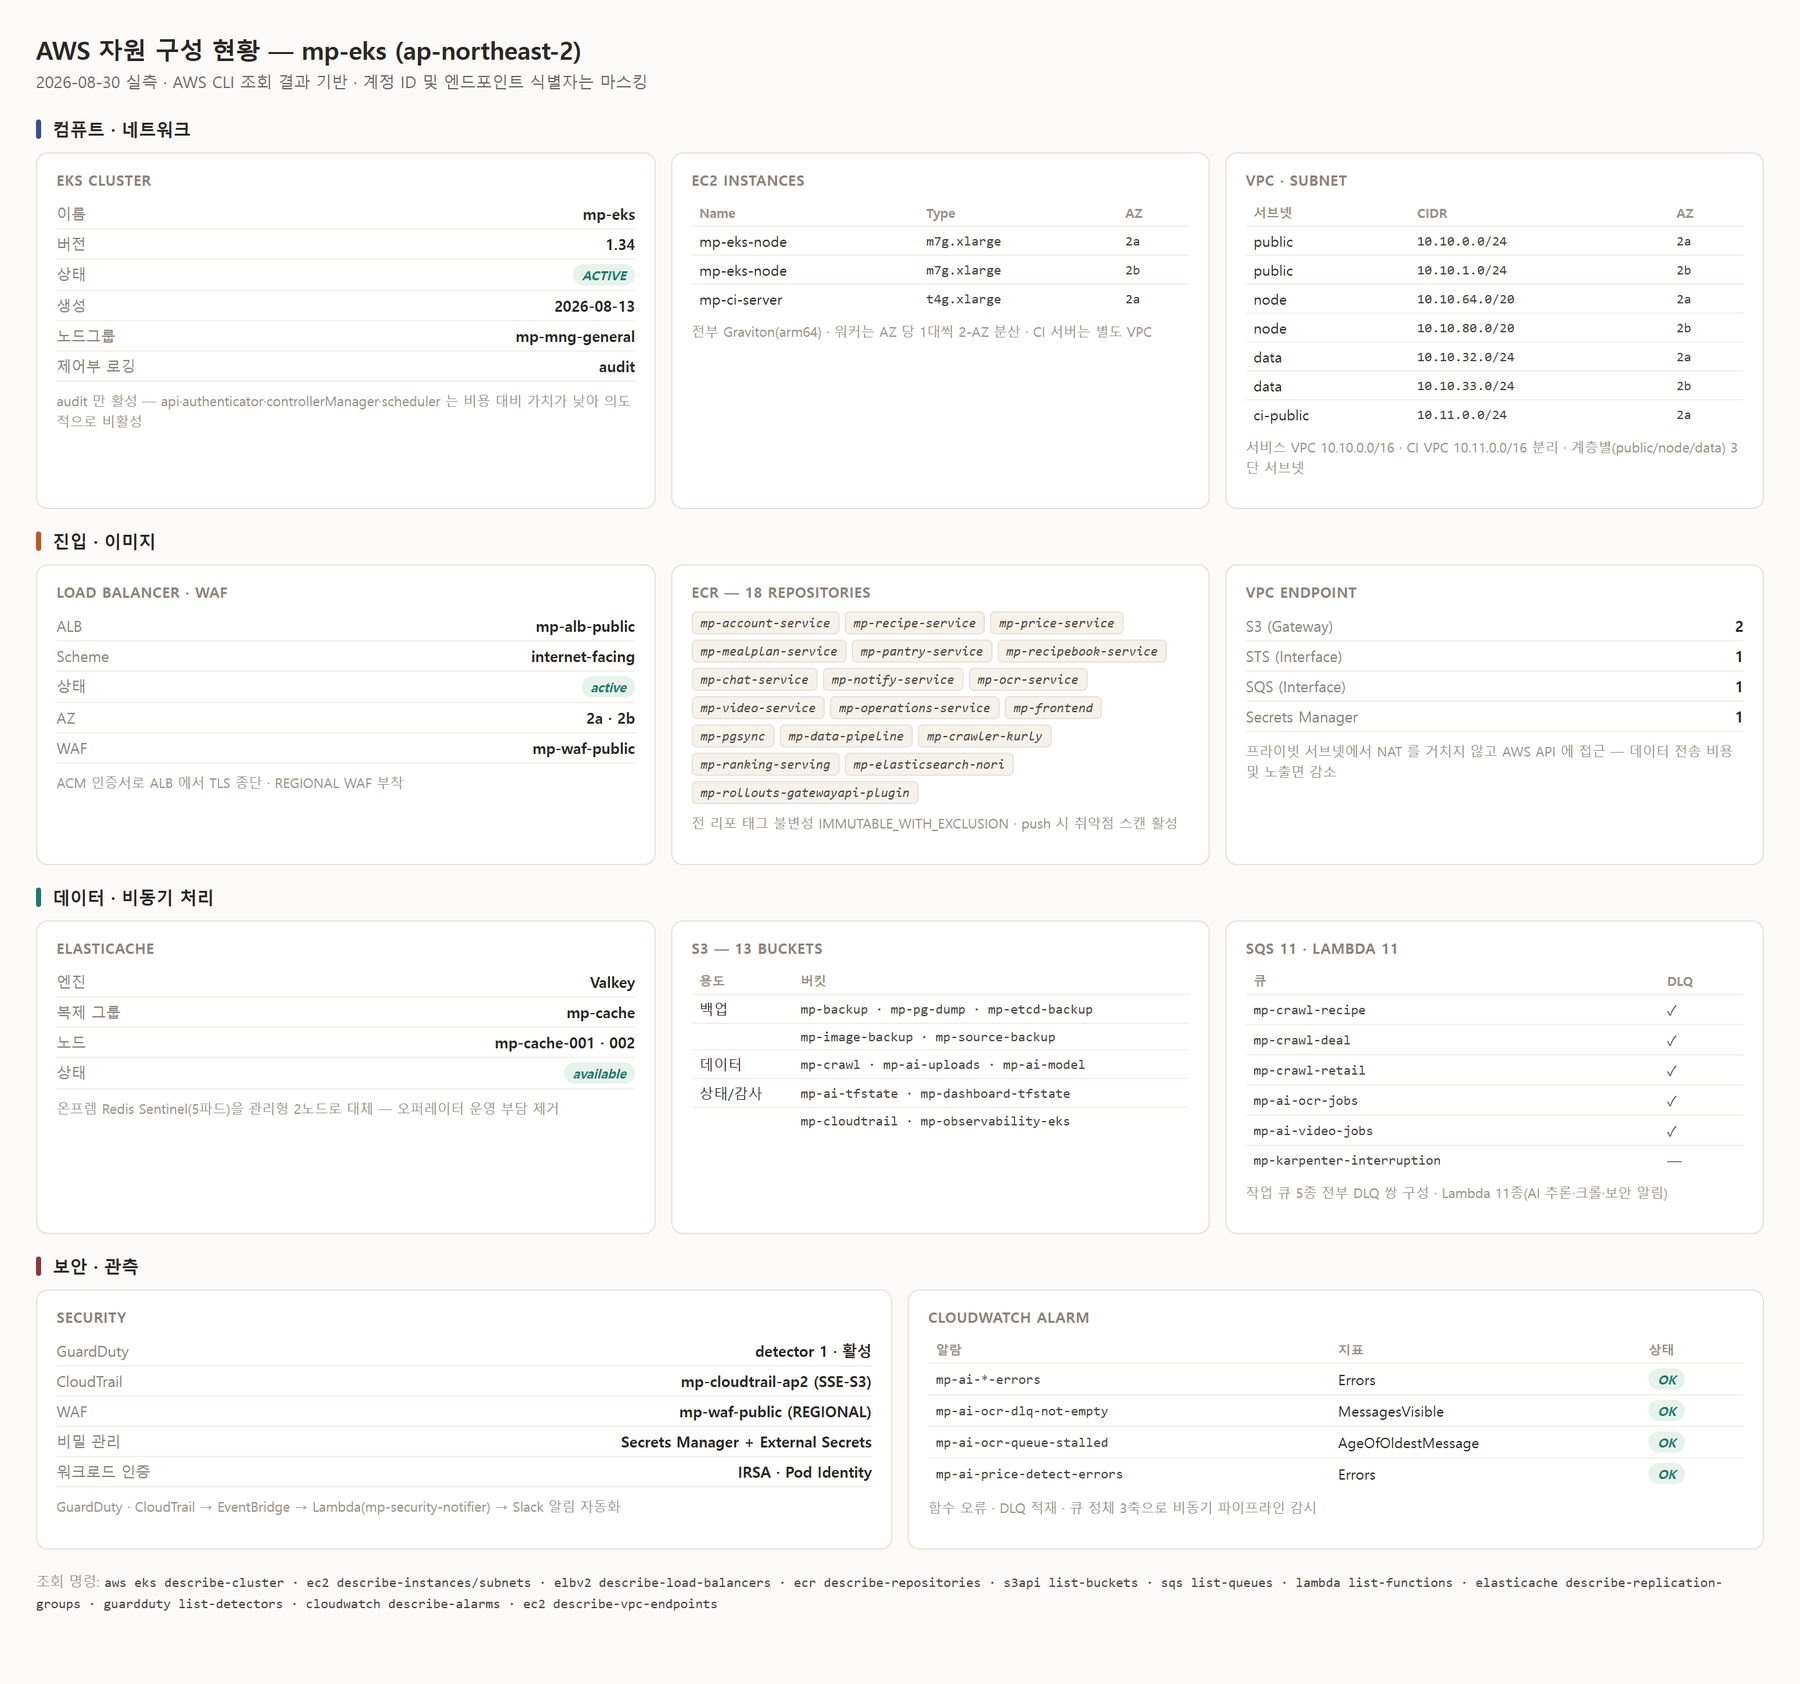
kubeadm 5노드(amd64) → EKS m7g.xlarge(Graviton) 2대 · 2개 가용영역
설계 과정에서 내린 결정을 번호로 관리했습니다. 선택한 것만이 아니라 검토했다가 쓰지 않기로 한 것과 그 이유를 함께 남겼습니다.
CNI는 Cilium↔ Calico
서비스 조회가 iptables 체인 순차 탐색에서 eBPF 해시 조회로 바뀌어, 서비스 수가 늘어도 성능이 유지됩니다.
라우팅은 VXLAN↔ native routing
native routing을 검토했으나 실측 결과 CPU 처리 한계가 2.25Gbps로 물리 회선 1GbE보다 커서, 회선이 먼저 포화되는 것을 확인하고 VXLAN으로 확정했습니다.
데이터 계층은 자체 운영↔ RDS · OpenSearch · MSK
비용과 함께 오퍼레이터로 상태 저장 워크로드를 운영하는 경험 확보를 목표로 자체 운영을 선택했습니다. AWS 이관 후에도 이 기준을 유지했습니다.
컴퓨트는 온디맨드↔ Spot
초기 계획을 실측 후 변경했습니다. 병목이 CPU가 아니라 메모리였고(CPU는 요청 대비 실사용 9.4배, 메모리는 1.1배), Blue-Green 배포에서는 승격 후 파드가 이동하지 않아 절감 효과가 제한적이라고 판단했습니다.
외부 진입은 ALB↔ NLB 패스스루
경로 기반 라우팅과 WAF 부착이 필요했습니다.
증상과 원인이 다른 계층에 있던 장애
Troubleshooting
다섯 건 모두 증상이 나타난 지점과 실제 원인이 있는 지점이 달랐습니다. 그래서 조치하기 전에 “이 증상이라면 원인은 여기여야 한다”는 가설을 세우고, 그 가설이 예측하는 다른 현상이 실제로 관측되는지 확인하는 방식으로 접근했습니다.
파드가 VPC 외부로 통신하지 못한 문제
증상: 인증 실패→원인: CNI 인터페이스명
증상
EKS로 이전한 뒤 일부 파드에서 외부 API 호출이 응답 없이 타임아웃으로 끝났습니다. 로그에는 인증 실패처럼 보이는 메시지가 남아 처음에는 IAM 권한을 의심했습니다.
단서
같은 Deployment의 파드인데 일부만 실패했습니다. 무작위가 아니라면 무언가를 기준으로 갈리고 있다는 뜻이었습니다.
원인
Cilium의 마스커레이드 대상 인터페이스를 eth0으로 지정했으나 AWS Nitro 인스턴스의 실제 인터페이스명은 ens5였습니다. 1차 ENI에 배치된 파드만 정상이었고, 2차 ENI 이후 파드는 출발지 주소가 변환되지 않아 밖으로 나가지 못했습니다.
조치
인터페이스 패턴을 en+로 변경해 해결했습니다.
로그가 인증 오류를 가리킨다고 해서 자격증명부터 재발급하면 같은 자리를 반복하게 됩니다. 일부에서만 발생하는 문제는 그 갈리는 기준을 먼저 찾아야 했습니다.
트래픽이 늘어도 파드가 생성되지 않은 문제
증상: 오토스케일러→원인: 네임스페이스 쿼터
증상
부하를 인가했는데 HPA가 목표 replica를 올려도 파드가 생기지 않았고 Karpenter도 반응하지 않았습니다.
단서
실패의 형태가 달랐습니다. 파드가 Pending이었다면 자원 부족이고 Karpenter가 노드를 증설했을 텐데, 실제로는 생성 자체가 되지 않고 ReplicaSet에 FailedCreate가 기록되어 있었습니다. Pending은 스케줄링 실패이고 FailedCreate는 생성 요청이 거부된 것입니다.
원인
네임스페이스 ResourceQuota가 6GiB인데 평시 사용률이 이미 84%였습니다. HPA가 파드를 요청하면 admission 단계에서 거부되었고, 거부된 파드는 존재하지 않으므로 Karpenter가 증설을 판단할 근거가 없었습니다.
조치
쿼터를 노드 용량보다 여유 있게 조정하고, 같은 실패가 조용히 넘어가지 않도록 거부 이벤트를 알림 대상에 추가했습니다.
“오토스케일러가 동작하지 않았다”가 아니라 “오토스케일러가 판단할 대상이 생성되지 않았다”가 정확한 설명이었습니다. 쿼터는 용량 계획이 아니라 과다 사용 차단이 목적이라고 정리했습니다.
가격 조회 실패 급증 — 평균 응답 시간은 정상
증상: 용량 부족→원인: 캐시 만료 패턴
증상
가격 조회 API의 실패가 급증했는데 평균 응답 시간은 정상으로 보였습니다.
원인
응답 시간 분포가 두 개의 봉우리로 나뉘어 있었습니다. 캐시가 유효할 때의 빠른 응답과 만료 시점의 지연이 평균에서 상쇄된 것입니다. 만료 순간 대기 중이던 요청이 한꺼번에 데이터베이스로 몰렸고, 해당 경로는 구체화 뷰가 없어 조회 비용이 컸습니다.
판단
이 문제는 HPA로 해결되지 않고 오히려 악화됩니다. replica를 늘리면 만료 시점에 데이터베이스로 요청을 보내는 주체가 그만큼 늘어나기 때문입니다.
조치
만료된 값을 우선 반환하고 백그라운드에서 갱신하는 방식과, 동일 키에 대한 갱신을 한 번만 수행하는 방식을 함께 적용해 조회 실패를 1,783건에서 2건으로 줄였습니다.
평균은 서로 다른 두 집단을 하나로 보이게 만듭니다. 분포를 보지 않았다면 용량을 늘리는 방향으로 갔을 것입니다.
매니페스트 레포지토리 충돌
증상: 협업 충돌→원인: CD 도구의 파일 처리
증상
매니페스트 레포에서 대부분의 PR이 충돌하고 주석이 계속 늘어났습니다. 누가 무엇을 지웠는지 서로를 의심하는 분위기가 생겼습니다.
원인
담당자를 찾는 대신 재현 조건을 먼저 특정했습니다(CD 실행 후에만 발생). CD 파이프라인이 이미지 태그를 갱신할 때 쓰는 kustomize edit이 파일을 다시 직렬화하면서 키 순서와 주석 위치를 바꾸고 있었습니다.
조치
원인이 사람이 아니라 자동화에 있다는 것을 커밋 이력으로 함께 확인하고 구조를 고쳤습니다.
제가 제안한 구조에서 생긴 문제였습니다. 방어하지 않고 재현 조건부터 잡으니 논의가 빠르게 정리됐습니다.
데이터 이관 정합성 판정 기준
문제: 완료 판정→해법: 체크섬 기준
문제
두 데이터베이스의 내용이 동일한지 판정할 기준이 필요했습니다. 행 수 비교는 UPDATE를 감지하지 못하고, 삭제 후 같은 건수를 삽입한 경우에도 통과합니다.
조치
41개 테이블 전체에 체크섬을 계산해 비교하는 SQL을 작성했고(약 7초 소요), 이관 판정과 이후 정기 점검에 같은 스크립트를 사용했습니다.
이관 작업에서는 절차보다 완료 판정 기준을 먼저 정하는 것이 중요했습니다. 기준이 없으면 작업이 끝났는지를 판단할 수 없습니다.
그 외 프로젝트
Projects
더존 클라우드 DX Academy 6기 과정에서 리눅스·데이터베이스·컨테이너·Kubernetes 순으로 진행한 팀 프로젝트입니다.
한정판 스니커즈 거래 플랫폼 Kubernetes 인프라
2026.05 – 06 · 3명
인프라 리드 — 클러스터 설계·구축, 서비스 메시, 보안, 오토스케일링, 부하 테스트
Ansible + Kubespray로 VM 9대 자동 구축, control-plane 3중화(etcd 3 · HAProxy LB)
Istio IngressGateway 단일 진입점(TLS 종료 · 80→443), VirtualService 5종 prefix 라우팅, mTLS STRICT
네임스페이스 5개 분리 + NetworkPolicy 34개로 ns 간 통신 차단, 팀원별 RBAC 3단계, Sealed Secrets
HTTP 서비스는 CPU 기반 HPA 4종, Kafka 컨슈머는 KEDA ScaledObject(lag 10 초과 시 스케일아웃)
k6 2종으로 스케일아웃 검증(20→300 VU · p95 2s · 에러율 5% 미만), Grafana 통합 대시보드 13개 패널